2026年9月15日
Matt Pocock 的 AI 驱动软件工程方法论
从实习项目中的需求澄清与返工经历出发,整理 Matt Skills 从想法到交付的工作流、Skill 速查、仓库初始化与上下文管理方法。
- ai
- software-engineering
- agent
- methodology
最近,需要负责启动一个新的 App 项目。项目一开始没有完整的产品文档,只有老板一些比较零散的想法。我和负责 UI 设计的同学需要从头推动 MVP 落地,但在实现过程中,我们对同一个功能的理解有时并不一致。等到设计或开发已经往前走了一段,才发现需要回头修改,花了不少时间。
后来我在这个项目里尝试了 Matt Skills:从 /ask-matt 判断当前工作该进入哪条流程,到功能规划,再到按 Ticket 实施和交付。它帮助我把原本容易留在讨论里的细节逐步说清楚,并留下后续工作可以对照的依据。在随后的 AI Agent 驱动开发中,我没有再遇到因需求细节约束不清、Coding Agent 实现偏了而重新返工的情况。
这篇文章会整理我对这套方法的理解、它怎样帮助项目推进,以及如何把这些 Skills 引入自己的项目;同时也留作我开发时的速查手册。
我把 Matt 的 Skills 理解为一套软件工程工作流路由系统:根据当前工作的状态选择合适入口,并在阶段边界留下可验证、可交接的工程产物。
这套方法串起了以下工作环节:
问题 → 决策 → 文档 → Ticket → 实现 → 验证。
快速开始
npx skills@latest add mattpocock/skills
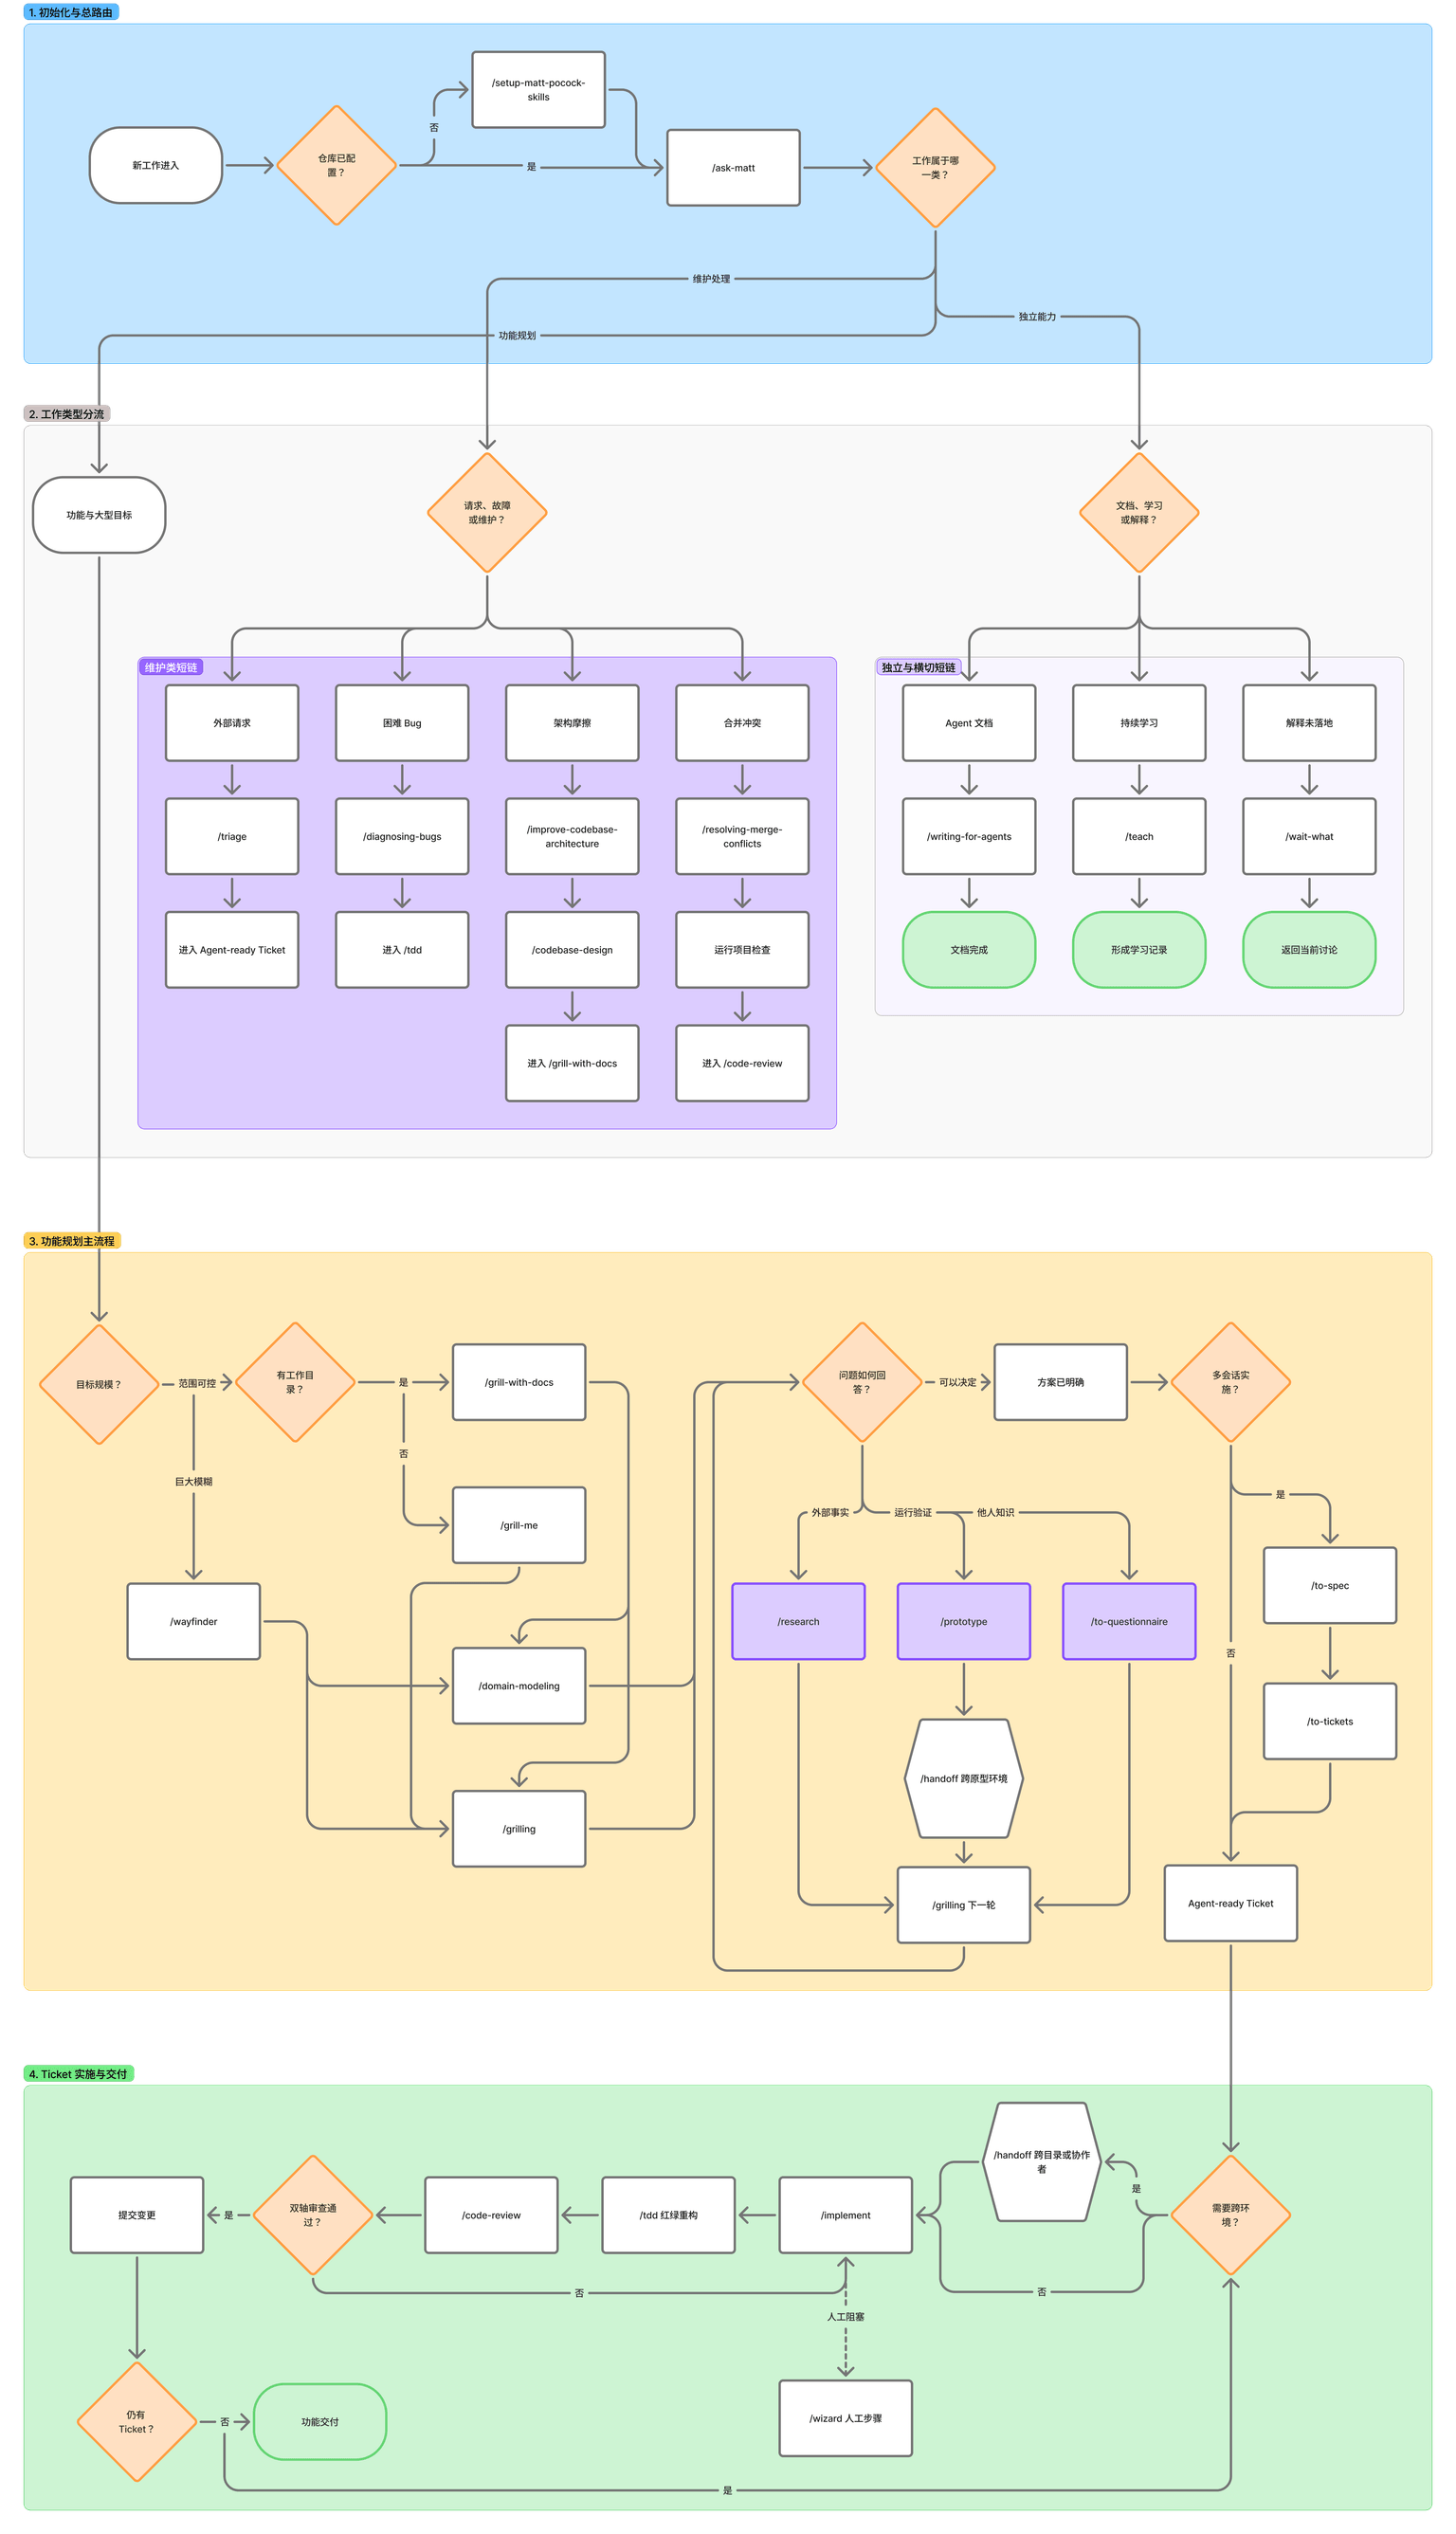

正式使用前,先运行 /setup-matt-pocock-skills 配置仓库;不确定下一步时,使用 /ask-matt 进行路由。
整体使用模型
这套方法包含一条“想法到交付”的主流程、若干特殊入口,以及贯穿全过程的领域和代码设计能力。
主流程:从想法到交付
- 澄清目标:在代码仓库中使用
/grill-with-docs;没有工作目录时使用/grill-me。 - 消除不确定性:
- 外部事实交给
/research; - 必须运行代码或观察 UI 的问题交给
/prototype; - 只有客户、同事或领域专家能回答的问题交给
/to-questionnaire。
- 外部事实交给
- 按工作规模分流:
- 小任务可以在当前上下文中直接进入
/implement; - 多会话任务先通过
/to-spec形成正式规格,再由/to-tickets拆成纵向切片。
- 小任务可以在当前上下文中直接进入
- 实现与验证:每个 Ticket 独立执行
/implement,内部使用/tdd推进,最后通过/code-review检查 Standards 与 Spec。 - 提交与交付:项目级检查通过后再提交变更,并把未完成事项放回 Ticket,而不是遗留在聊天记录里。
特殊入口
| 当前情况 | 使用的 Skill | 后续流向 |
|---|---|---|
| 收到未经整理的 Bug、需求或 PR | /triage | 形成 Agent-ready Ticket 后进入 /implement |
| 遇到难以复现、难以定位的 Bug | /diagnosing-bugs | 建立反馈循环,再通过 /tdd 修复 |
| 面对一次会话无法规划的大型目标 | /wayfinder | 逐个解决决策 Ticket,再进入 /to-spec |
| 发现模块边界差、修改成本高 | /improve-codebase-architecture | 形成改进想法,再进入 /grill-with-docs |
| 正在解决 Merge/Rebase 冲突 | /resolving-merge-conflicts | 按双方原始意图完成冲突解决 |
/triage只处理外部进入的原始工作;/to-tickets生成的 Ticket 已经是 Agent-ready。/wayfinder负责消除大型目标中的决策迷雾,本身不负责交付代码。/prototype只回答一个设计问题,不应自然演变成未经审查的生产实现。/research提供事实和证据,但不会代替人做产品决策。
贯穿流程的基础能力
domain-modeling维护统一的领域语言,避免同一个词在不同模块中表达不同含义;codebase-design使用深模块、接口、接缝和局部性等概念设计代码结构;handoff在跨会话、跨目录或跨协作者时生成可移交的上下文;wizard把必须由人执行的控制台、凭据或迁移步骤整理成可重复流程;wait-what在解释没有讲清楚时,用当前项目的领域语言重新说明。
Skill 速查
入口与环境配置
| Skill | 一句话用途 |
|---|---|
ask-matt | Skill 导航器。根据当前工作状态,帮你选择应该进入哪条 Skill 流程。 |
setup-matt-pocock-skills | 项目初始化工具。为仓库配置 Issue Tracker、Triage 标签和领域文档布局。 |
需求澄清与大型规划
| Skill | 一句话用途 |
|---|---|
grilling | 通过分轮决策树采访,把计划中的所有隐含问题逐项问清楚。 |
grill-me | 在没有项目工作区时进行一次不保存文档的需求或方案采访。 |
grill-with-docs | 在仓库中澄清方案,并同步维护领域词汇和必要 ADR。 |
wayfinder | 把无法在一次会话中想清楚的大型目标组织成决策地图,逐步消除不确定性。 |
research | 基于官方文档、标准和源代码研究外部事实,并将结论写成带引用的文档。 |
prototype | 用可丢弃的运行代码回答一个仅靠讨论无法确定的设计问题。 |
to-questionnaire | 把只有外部人员才能回答的知识缺口整理成针对性问卷。 |
领域和架构设计
| Skill | 一句话用途 |
|---|---|
domain-modeling | 统一领域术语、澄清业务对象边界,并在必要时记录 ADR。 |
codebase-design | 用深模块、接口、接缝和局部性等概念设计易维护、易测试的代码结构。 |
improve-codebase-architecture | 扫描代码库中的架构摩擦,找出值得深化模块或重构的机会。 |
规格与实施
| Skill | 一句话用途 |
|---|---|
to-spec | 将已经讨论清楚的决定综合成正式、可实施的 Spec,不再发起新采访。 |
to-tickets | 将 Spec 拆成带阻塞关系、可独立验收的纵向切片 Ticket。 |
implement | 按 Spec 或 Ticket 完成实现、验证和交付。 |
tdd | 使用红—绿—重构循环,以可观察行为驱动代码实现。 |
code-review | 从固定基点分别检查代码是否符合仓库规范以及是否满足 Spec。 |
请求、故障与代码维护
| Skill | 一句话用途 |
|---|---|
triage | 将外部 Bug、需求和 PR 整理、验证并推进成 Agent-ready 工作。 |
diagnosing-bugs | 先建立能稳定复现问题的反馈循环,再定位根因并补充回归测试。 |
resolving-merge-conflicts | 根据两边变更的原始意图逐个解决 Merge 或 Rebase 冲突。 |
上下文、人机协作与知识维护
| Skill | 一句话用途 |
|---|---|
handoff | 把当前上下文压缩成可供另一会话、目录或协作者接手的临时文档。 |
wizard | 为必须由人操作的控制台、凭据、迁移或切换流程生成交互式 Bash 向导。 |
wait-what | 当上一段解释没有讲明白时,使用项目领域语言重新简明解释。 |
teach | 在工作区中建立可持续、多轮次的课程、参考资料和学习记录。 |
writing-for-agents | 指导如何编写稳定、明确、可被 Agent 正确消费的 Skill 和 Agent 文档。 |
仓库初始化
/setup-matt-pocock-skills
初始化回答三个问题:
- 这个项目在哪里管理需求和 tickets?
- 项目使用什么 triage 状态语言?
- Agent 应该从哪里读取领域知识和架构决策?
典型产物:
project/
├── AGENTS.md 或 CLAUDE.md
├── CONTEXT.md                     按需创建
├── docs/
│   ├── agents/
│   │   ├── issue-tracker.md
│   │   ├── domain.md
│   │   └── triage-labels.md        安装 triage 时才有
│   └── adr/
│       └── 0001-*.md              有重要决策时才创建
└── src/
其中:
docs/agents/issue-tracker.md是“工作发布到哪里”的操作约定;docs/agents/domain.md是 Agent 阅读领域文档的规则;docs/agents/triage-labels.md是通用状态和实际 Tracker 标签之间的映射;CONTEXT.md是稳定、共享的领域词汇表;docs/adr/保存少量重要、难以逆转的架构决策。
Issue Tracker
决定 spec 和 ticket 保存在哪里:
- GitHub Issues
- GitLab Issues
- 本地 Markdown:
.scratch/<feature>/ - Linear、Jira 或其他自定义工作流
上下文管理也是工程设计
在 AI 驱动的软件工程中,上下文是一种有限资源。
规划阶段最好保持一段连续上下文:
grilling → research/prototype → to-spec → to-tickets
这些步骤共享同一套问题、事实和决策。进入实施阶段后,每个 Ticket 则应该从干净上下文开始,只依赖 Spec、Ticket、领域文档和当前代码。
在阶段边界,可以按以下顺序判断:
- Continue:当前上下文仍然清晰,直接继续;
- Clear:后续工作不再需要当前上下文;
- Handoff:需要跨目录、跨会话或交给其他协作者;
- Subagent:把边界明确的支线任务交给独立上下文;
- Compact:会话接近 smart zone 上限时压缩上下文。
关键不是频繁清理上下文,而是在正确的阶段边界处理它。规划尚未形成稳定产物时过早清空,会丢失重要推理;实现不同 Ticket 时持续携带旧上下文,又会积累大量无关信息。
人与 Agent 的职责边界
| 人负责 | Agent 负责 |
|---|---|
| 业务目标、价值判断和产品取舍 | 发现未决问题并组织讨论 |
| 确认产品范围和验收标准 | 调查事实、阅读代码并生成证据 |
| 批准不可逆或高风险决策 | 维护 Spec、Ticket、测试和文档 |
| 提供凭据并完成必须人工操作的步骤 | 按 Ticket 实现、验证和审查代码 |
/wizard 用于真正需要人参与的步骤,例如配置凭据、操作第三方控制台或执行切换流程。Agent 能安全完成的事情不应推给人;必须由人判断或授权的事情,也不应由 Agent 擅自决定。
我的理解
Matt 的方法论不是让 Agent 完全替代工程师,而是把优秀工程师原本隐性的工作方式显式化:
- 先建立共享语言,再讨论方案;
- 先消除关键不确定性,再投入生产实现;
- 用文档和 Ticket 跨越上下文边界;
- 用测试、审查和证据约束 Agent 的输出;
- 让人保留产品判断和高风险决策权。
AI 提高的是执行速度,工程方法决定的是方向、质量和可持续性。